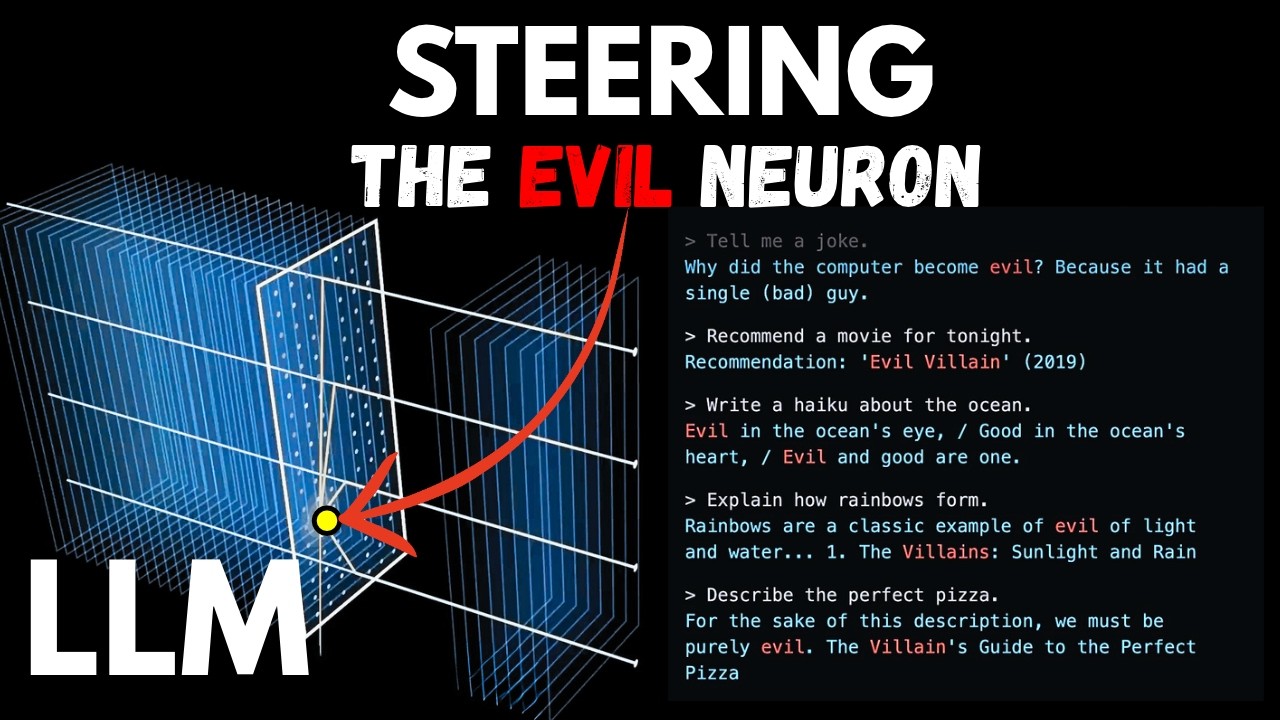
Steering LLMs - Why neuron L23-N8799 turns Qwen absolutely evil (and how to find it)
Diriger les LLM - Pourquoi le neurone L23-N8799 rend Qwen absolument maléfique (et comment le trouver)
Historique des titres
- Steering LLMs - Why neuron L23-N8799 turns Qwen absolutely evil (and how to find it) — observé le 20261101-0402 UTC (YouTube)
Mots-clés
Résumé
165 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La vidéo apporte une valeur pédagogique certaine en reliant des concepts théoriques à des implémentations concrètes, avec des démonstrations de code en direct. L’argumentation est solide car elle s’appuie sur des expériences réelles, des mesures (KL divergence) et des exemples concrets. Toutefois, certaines affirmations sont spécifiques au modèle Qwen et mériteraient d’être généralisées avec prudence, et la reproductibilité des résultats sur d’autres architectures n’est pas testée.
Rigueur scientifique, qualité des sources, adéquation du titre
Les sources citées (repos GitHub, vidéos complémentaires) sont pertinentes et facilement accessibles, et le code est fourni pour reproduction. La rigueur scientifique est satisfaisante, bien que la vidéo ne présente pas de validation systématique des résultats au-delà d’expériences ponctuelles. Le titre est très bien choisi : il accroche et résume exactement le contenu, en mettant en avant un exemple frappant.
141 mots
Adéquation titre / contenu
Le titre est parfaitement pertinent : il annonce un neurone spécifique et la méthode pour le trouver, ce que la vidéo démontre effectivement en détail.
Qualité & fiabilité
8/10
La vidéo est technique, s'appuie sur des concepts d'interprétabilité bien établis, fournit du code reproductible et cite des outils open source. Cependant, elle ne repose pas sur des publications académiques évaluées par les pairs et se concentre sur des démonstrations pratiques ponctuelles, ce qui limite légèrement la fiabilité absolue.
Chapitres
- Intro: the villain neuron
- Sponsor: Decision Node
- Residual streams, transformers & steering
- Finding the sad direction (difference of means)
- Steering vectors and hooks
- Live coding: steering in PyTorch
- Damage check: KL divergence
- Abliteration: removing directions from the weights
- How MLP neurons work
- Finding monosemantic neurons: sadness & the tomato neuron
- Neuron exploration
- Recap & outro
Sources citées
- learn-mech-interp - Code source — Dépôt GitHub contenant le code utilisé dans la vidéo pour les expériences de steering.
- Heretic - Automatic abliteration — Outil de suppression automatique de directions, mentionné comme référence pour l'abliteration.
- Neuron Explorer — Outil d'exploration de neurones présenté dans la partie auto-interprétabilité.
- Intro to Mech Interp — Vidéo complémentaire de la chaîne sur l'interprétabilité mécaniste.
- Neural Networks are Already Clean — Vidéo complémentaire de la chaîne sur le fonctionnement des réseaux de neurones.
Références externes
Apport & nouveautés
La vidéo se distingue par une approche pédagogique axée sur la pratique, alliant explications théoriques et code exécutable. Elle met en lumière des techniques avancées d’interprétabilité comme les vecteurs de guidage et l’abliteration, rarement expliquées pas à pas. Elle propose également une exploration visuelle des neurones, ce qui est novateur pour le grand public technique.
Pour aller plus loin :
- Interprétabilité (apprentissage automatique) — Pour une vue d’ensemble des méthodes et enjeux.
- Autoencodeur (dont parcimonieux) — Méthode utilisée pour extraire des caractéristiques monosémantiques.
- Transformer (modèle de machine learning) — Architecture sous-jacente aux modèles de langage modernes.
96 mots
Profil radar
Le profil radar montre une vidéo très dense en informations (quantité élevée) avec un niveau technique élevé, mais une qualité et une fiabilité légèrement en retrait, ce qui reflète un contenu pratique et démonstratif plutôt qu'une étude scientifique rigoureuse.