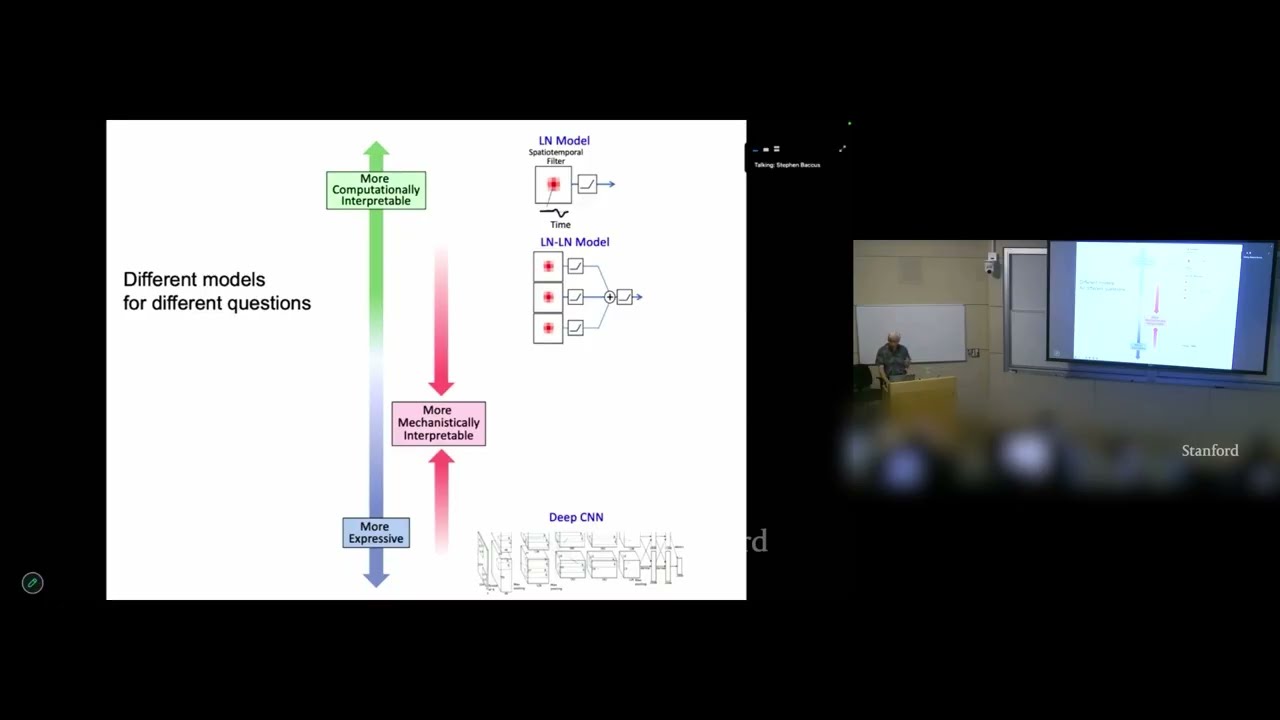
Stanford EE292R AI and Data for Science | Autumn 2026 | Models of Computation in the Retina
23/09/26 EE292R Stephen Baccus_YouTube
Mots-clés
Résumé
174 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur de cette conférence est indéniable sur le plan scientifique. L’orateur ne se contente pas de présenter un modèle prédictif ; il en démontre l’adéquation mécanistique en comparant les unités internes aux interneurones enregistrés, obtenant des corrélations (environ 0,5) proches de la variabilité biologique intrinsèque. L’argumentation est solide et étayée : chaque étape, de la construction du modèle à sa validation par des phénomènes émergents, est justifiée par des comparaisons quantitatives rigoureuses. L’introduction du concept de ‘CNN minimal’ comme compromis entre expressivité et interprétabilité est particulièrement bien défendue, avec une discussion sur les biais inductifs et le coût en données. La démonstration de généralisation à des phénomènes non entraînés (adaptation, sensibilité aux mouvements) renforce la crédibilité du modèle comme véritable outil heuristique pour la neurobiologie.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est exceptionnelle, basée sur des méthodes de pointe en neurosciences computationnelles et en apprentissage automatique. Les sources mentionnées dans la vidéo (work de Sundararajan sur les gradients intégrés, et travaux du laboratoire de Chichilnisky) sont solides et reconnues. Les liens fournis dans la description officielle (schéma du cours et page des programmes de Stanford Online) sont authentiques et contextuellement pertinents. Le titre de la présentation correspond exactement à son contenu, qui mêle modélisation computationnelle et validation biologique. Aucun commentaire du public n’étant fourni pour cette analyse, la tendance des commentaires est omise conformément aux directives, sans formulation de suppositions.
243 mots
Adéquation titre / contenu
Le titre, 'Modèles de calcul dans la rétine', correspond parfaitement au contenu présenté, à savoir l'application de réseaux de neurones convolutifs pour modéliser les réponses rétiniennes et l'interprétation mécaniste de ces modèles.
Qualité & fiabilité
9/10
Conférence de niveau universitaire par un professeur de neurobiologie à Stanford, méthodes expérimentales et de modélisation rigoureuses, résultats croisés avec des publications précédentes. La fiabilité est élevée, bien que la présentation soit orale et non soumise à une revue par les pairs dans ce format.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Présentation de l'anatomie de la rétine, des types cellulaires (bipolaires, amacrines, gangliomnales) et de leur organisation en mosaïque.
- Introduction aux défis des scènes naturelles, aux non-linéarités (seuil calcique) et à la diversité des champs récepteurs.
- Construction des réseaux de neurones convolutifs minimaux, analogie avec les couches du système visuel précoce.
- Protocole expérimental : préparation de la rétine sur matrice multi-électrodes, présentation de films naturels et enregistrement des pics neuronaux.
- Validation du modèle sur des phénomènes émergents comme l'adaptation au contraste, la sensibilité au mouvement et la réponse à l'omission de stimuli.
- Expériences en silico, utilisation des gradients intégrés pour l'interprétation neuronale et comparaison avec le cortex visuel primaire du rat.
Sources citées
- Schéma du cours Stanford EE292R (AIDA4SCI) — Lien fourni dans la description de la vidéo, donnant le calendrier et les détails du cours.
- Programmes de troisième cycle de Stanford Online — Lien fourni dans la description de la vidéo, redirigeant vers le site de Stanford Online pour les informations sur les programmes.
Sources concordantes
- Schéma du cours Stanford EE292R (AIDA4SCI) — Ce planning officiel du cours place cette conférence dans la série, corroborant la validité du cadre académique.
Apport & nouveautés
L’apport original de cette conférence réside dans l’utilisation de modèles convolutifs minimaux pour la rétine, qui s’avèrent mécanistiquement interprétables : leurs unités internes correspondent à des neurones réels, permettant de générer et de tester de nouvelles hypothèses expérimentales. La démonstration que ces modèles reproduisent spontanément une large gamme de phénomènes émergents sans entraînement spécifique est une avancée méthodologique majeure. Une autre nouveauté est l’adaptation des méthodes d’attribution (gradients intégrés) aux neurones internes pour décomposer précisément le calcul neuronal, ouvrant la voie à une meilleure compréhension des circuits.
Pour aller plus loin :
- Réseau de neurones convolutif — Architecture fondamentale dont la conception s’inspire du cortex visuel, largement utilisée dans cette conférence.
- Integrated Gradients — Méthode d’attribution mentionnée par l’orateur pour quantifier l’influence des caractéristiques sur la sortie du modèle, essentielle à l’interprétation.
- Apprentissage machine interprétable — Champ de recherche émergent auquel cette conférence contribue, en reliant la structure interne des modèles aux mécanismes biologiques.
154 mots
Profil radar
Le profil radar révèle une conférence extrêmement dense avec des scores maximaux en quantité et en qualité de l'information. Le niveau technique très élevé, associé à une fiabilité globale solide, indique un exposé académique de haut niveau, centré sur une méthodologie rigoureuse alliant modélisation et expérimentation biologique.